安全态势感知与机器学习 数据预处理与特征工程中的数据处理
在安全态势感知(Security Situation Awareness, SSA)系统中,机器学习模型的效果高度依赖于输入数据的质量。来自防火墙、入侵检测系统(IDS)、终端日志、NetFlow流量、威胁情报等多源异构数据往往存在噪声大、维度高、时间戳不一致、标注稀缺等问题。因此,数据预处理与特征工程成为连接原始安全数据与机器学习模型的关键环节,而其中的数据处理更是整个流程的基础与核心。
一、安全态势感知数据的典型特征
安全态势感知数据具有以下特点:
- 多源异构性:包括结构化日志(如Syslog、JSON)、半结构化流量记录(如NetFlow、PCAP)以及非结构化文本(如告警描述、威胁情报)。
- 高维度与稀疏性:原始流量特征维度可达数百维,且正常行为占据绝大多数,异常样本稀疏。
- 时间序列性:安全事件具有明显的时间先后关系,滑动窗口、会话聚合等处理必须保留时序语义。
- 标签稀缺与不平衡:真实环境中攻击标注极少,需要依赖半监督或弱监督手段。
- 概念漂移:攻击手法不断演化,数据分布随时间变化,预处理策略需具备在线适应性。
二、数据处理的总体流程
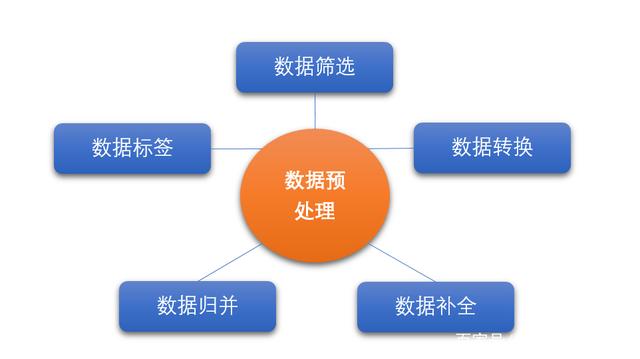
面向安全态势感知的数据处理可归纳为五个阶段:数据采集与接入、数据清洗、数据变换与规约、数据集成、数据划分与采样。每个阶段都直接影响后续特征工程与模型训练的可靠性。
三、数据清洗
数据清洗是数据处理的第一个关键步骤,目标是消除噪声、缺失值与不一致性。
- 缺失值处理:安全日志中字段缺失常见(如源端口为空、地理信息缺失)。可采用删除、均值/中位数填充、基于模型预测填充,或对缺失本身进行指示编码(missing indicator),以避免信息丢失。
- 噪声与异常值处理:流量统计中的极值可能来自采集错误而非真实攻击。可采用3σ准则、IQR箱线图法、孤立森林等无监督方法识别并修正异常值,同时需谨慎区分“异常值”与“真实攻击信号”。
- 重复与冗余记录去除:基于哈希或关键字段(五元组+时间戳)去重,防止模型因重复样本产生偏差。
- 格式规范化:统一时间戳格式(如统一为UTC毫秒)、统一IP表示、统一协议与端口命名,消除同一实体多种表示带来的歧义。
四、数据变换与规约
- 归一化与标准化:对流量字节数、连接时长等连续特征采用Min-Max归一化或Z-score标准化,消除量纲差异,提升基于距离的模型(如KNN、SVM)的稳定性。
- 离散化与分箱:将连续的时间间隔、端口号等按业务语义分箱,增强可解释性并降低噪声敏感度。
- 编码变换:对协议类型、事件类型等类别特征采用One-Hot、Label Encoding或目标编码(Target Encoding),后者在类别基数大时更高效,但需防止标签泄漏。
- 数据规约:通过主成分分析(PCA)、特征聚合(如按源IP聚合会话统计)或抽样降低数据规模,在保留关键安全语义的前提下提升处理效率。
五、数据集成
多源数据集成需要解决实体对齐与冲突消解问题。常用方法包括:以IP、设备ID、时间窗口为关联键进行跨源关联;采用统一的时间基准进行事件对齐;对同一字段在不同源中的冲突值,依据数据源可信度或时间新旧进行加权裁决。集成后的宽表为后续特征工程提供了统一视图。
六、数据划分与采样
- 时间序列划分:安全数据不宜随机划分,应按时间先后划分训练集、验证集与测试集,避免未来信息泄漏,真实评估模型对新型攻击的泛化能力。
- 不平衡采样:针对攻击样本稀缺,可采用过采样(SMOTE及其变体)、欠采样或代价敏感学习;但需注意SMOTE在时间序列与网络流量场景下可能生成不真实样本,应结合业务约束谨慎使用。
- 数据增强:通过窗口滑动、轻微扰动、会话重组等方式扩充少数类样本,提升模型鲁棒性。
七、面向特征工程的数据处理要点
数据处理应服务于后续特征工程:保留时序上下文以支持滑动窗口统计特征;保留原始实体标识以支持图特征构建(如IP通信图);对聚合前的原子事件进行清洗,避免“脏数据聚合放大误差”。应为概念漂移预留在线更新机制,如滑动窗口重算统计量、定期重训标准化参数。
八、实践建议
- 建立数据质量监控:对缺失率、重复率、分布偏移设置阈值告警。
- 保持处理流水线可复现:将清洗、变换、采样参数固化并版本化管理。
- 领域知识驱动:安全场景下的“异常”需结合攻击语义判断,避免机械式清洗抹除攻击痕迹。
- 隐私与合规:对IP、账号等敏感字段进行脱敏或哈希化处理,满足数据安全要求。
在安全态势感知与机器学习的结合中,数据处理并非简单的“清洗—转换”操作,而是决定模型能否捕捉真实威胁的关键工程环节。只有在缺失值、噪声、多源集成、时序划分与不平衡采样等方面进行系统化、可复现的处理,才能为特征工程与模型训练奠定可靠基础,从而提升态势感知系统的检测精度与响应能力。
如若转载,请注明出处:http://www.chinaapmdata.com/product/97.html
更新时间:2026-11-07 11:09:05